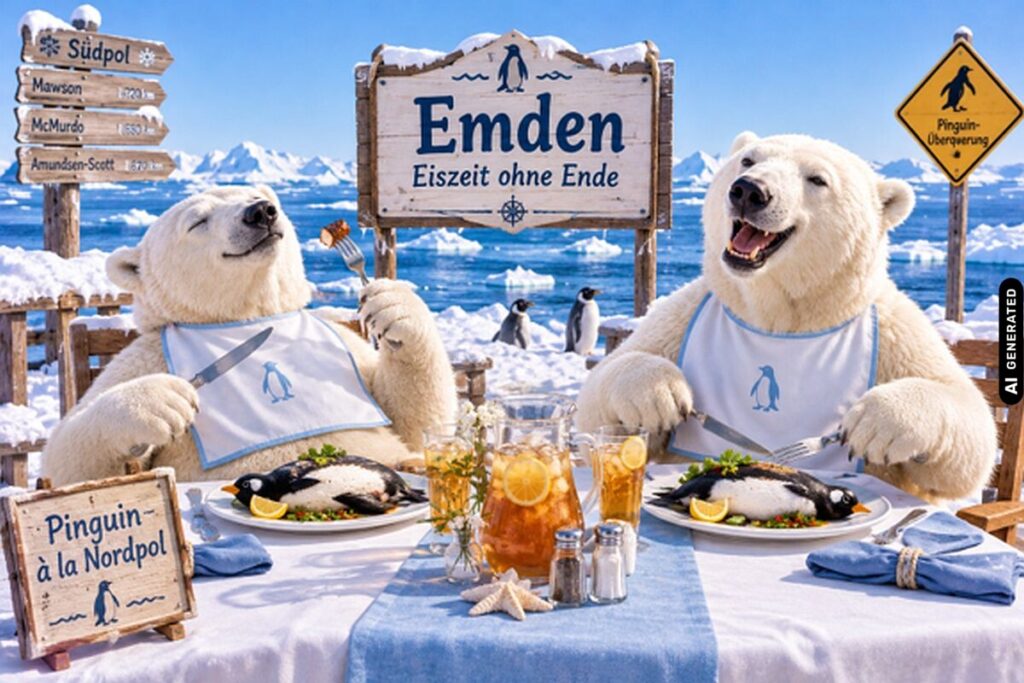
Wenn alle Pinguine gefressen sind, würde das Ökosystem kollabieren und das Schlaraffenland für die Eisbären wäre schlagartig vorbei.
Dieser Transformer-generierte Satz ist korrekt formuliert, zugleich unsinnig und offenbart die der generativen KI zugrunde liegende Architektur.
Wie alles begann:
Maschinelle Übersetzung
Die generative KI begann als Übersetzungstool bei Google Translate. Dessen Architektur bestimmte ihre Funktionsweise.
Jede rechnergestützte Übersetzung kodiert den Eingabestapel der Quellsprache in eine maschinenlesbare universelle Repräsentation (Encoder), die in die Wortfolge der Übersetzung ausgegeben wird (Decoder). Damit das funktionieren kann, ist die Zielsprache als Wortliste in einer möglichst vollständigen steuernden Parameterdatei namens Language Model verknüpft. Mit den Parametern wird das statistisch wahrscheinlichste passendste Wort aus der Liste ausgegeben.
Bei hohen Wortstapeln erwies sich jede noch so schnelle CPU-Prozessor als Flaschenhals im Übersetzer. Jeder Auftrag musste sequenziell nacheinander bearbeitet werden. Und so wechselten die Googlianer 2017 auf die GPU-Grafikchip–Technologie etwa der weit verbreiteten Nvidia-GP100, auf denen damals 6 GPUs schnell die Pixel auf dem Bildschirm adressieren konnten.
Google nutzte dabei die eigene Forschungsarbeit „Attention is all you need“. In dem dort beschriebenen Aufmerksamkeitsmechanismus werden alle Wörter des Eingabestacks als vieldimensionale Vektoren gleichzeitig in ein Kontextfenster geladen. Jeder Vektor sendet Anfragen an die übrigen Vektoren, und die Rückmeldung aller führt zu so etwas wie der Selbstdefinition aller Vektoren untereinander – Self-Attention. Die Vektoren werden mit Hilfe des Sprachmodells in Vektoren der Zielsprache verwandelt und schließlich dekodiert. Diese neue Architektur ist das Neuronale Netzwerk namens Transformer.
Maschinelle Kognition
Jedes Übersetzungsprogramm muss auch Bedeutungen übertragen, von Quell- auf Zielsprache interpretieren, Nuancen erhalten. Mit wachsenden Vektorenräumen, größeren Sprachmodellen und schnellem Durchsatz durch mehr GPUs wachsen die Fähigkeiten des Transformers.
Aus dem multilingualen Sprachmodell des Übersetzers mit etwa 200 Millionen Parametern wurden die Large Language Models (LLM) mit bis zu 2,8 Billionen Parametern. Deren Parameter bilden jetzt zusätzlich das gesamte sprachliche Weltwissen ab.
LLMs sind ebenfalls mit dem Aufmerksamkeitsmechanismus trainiert. Jeder Parameter ist durch alle anderen Parameter definiert, definiert umgekehrt diese, hat alleine keine eigene Bedeutung.
Der Quelltext ist jetzt nicht mehr der lange Stack der Ursprungssprache und hat auch keinen eigenen Encoder im Kontextfenster. Der Quelltext heißt ab jetzt Prompt, ist Auslöser, und seine mathematischen Repräsentationen halten sich als Vektorenraum im Speicher des Decoders auf.
Zu übersetzen gibt es normalerweise nichts mehr, trotzdem wird transformiert – vom Stack des Prompts in das, was wir als Antwort am Bildschirm wahrnehmen: Die Vektoren unseres Prompts fließen durch das Große Sprachmodell – zusammen, aber jeder einzeln angetrieben von einem der vielen tausend Rechenkerne ehemaliger Grafikkarten.
Sie finden in den früher trainierten, unveränderlichen Parametern naheliegende Assoziationen. Ein nichtlineares, mathematisches Verfahren filtert diese Verbindungen auf Relevanz, verwirft diese oder spricht ihnen Gewicht zu und gibt sie weiter an den nächsten ablaufgleichen Block.
Unser vieldimensionaler Prompt-Vektorraum namens Logit-Vektor ist jetzt angereichert mit all dem Weltwissen des Modells, kann vor Kraft weder gehen noch einen Ton von sich geben. Aber genau darum geht es überhaupt in der Inferenz, der Generierungsphase des Transformers: Wie heißt das nächste Token, das statistisch wahrscheinlichste Folgewort auf unseren Eingabeprompt? Bei einem deutschsprachigen Prompt muss das Folgewort eines der etwa 50.000 Wörter umfassenden deutschen Wortliste sein. Jedes erhält einen Koeffizienten zwischen 0 und 1, und da liegt der Kandidat für das Token/Wort vorne, der am nächsten an der 1,0 steht.
Dieses erste Folgewort erscheint auf dem Bildschirm, und gleichzeitig wird das Token zum Bestandteil des um das Token erweiterten Prompts gemacht. Das Konzentrat aus menschlicher Anfrage und Weltwissen wird Teil der Suche nach dem nächsten Wort – autoregressiv. Das errechnete Ergebnis wird Teil des Suchlaufes der Eingabe. Und dann noch ein Wort und noch eins bis zum definierten Ende.
Die Verlängerung des Prompts wird nun graduell immer stärker durch die wahrscheinlichsten nächsten Wörter geprägt, führt ein Eigenleben, das sich wie eine intelligente Antwort liest.
Der Prompt
“An welchem Fluss liegt Kalkutta?”
wird vermutlich verlängert zu
“Kalkutta liegt am Ganges”,
weil Kalkutta das häufigste Folgetoken der sechs Prompt-Token ist, gefolgt von liegt, weil Millionen von Modellparameter darauf deuten. Und so weiter.
(Lautet die Verlängerung allerdings Kalkutta liegt an Madeleine, dann handelt es sich wirklich um eine Halluzination.)
Wir Promptler lesen den Text, freuen uns, wie unser intelligentes Gegenüber auf uns eingegangen ist, uns gewürdigt und dabei alles geografische Wissen dieser Welt mobilisiert hat. Aber eines sehen wir nicht unbedingt: Wir haben nur unsere eigene Projektion gelesen. Denn unser Prompt war der Pfadfinder im Meer der Milliarden Parameter.
Wir bewegen uns jetzt in einem promptzentrierten Weltbild.
Der Auslösende hat keine Antwort auf seine Frage, keine Reaktion auf einen Impuls ausgelöst. Der Prompt fließt einfach dahin und generiert das wahrscheinlichste nächste Wort. Es sitzt niemand auf der anderen Seite des Vorhangs, da ist nur seine eigene Fragestellung, nur seine Intention, Antworten zu finden.
Auch der Prompt
Was passiert, wenn man 1000 Eisbären in die Antarktis verfrachtet?
fließt nur so dahin und erzeugt eine durchaus vernünftige Verlängerung. Das Modell hat aber auch unsere Wortwahl zu einer Antwort verlängert.
Kontextfenster
Doch hier passiert meist noch mehr.
Der Eingabeprompt füllt nicht alleine den Vektorraum. Noch vor dem ersten Wort stehen hier bereits die Vektoren des System-Prompts, der von den Servern der Anbieter stammt. Das sind übergreifende Formulierungsregeln, Rollenanweisungen der KI, die als strikte Anweisungen auch als solche intern gekennzeichnet sind und über den Eingaben der Nutzer stehen.
All die geschickten Gliederungen, die Umwandlung der Prompt-Verlängerung in eine scheinbare Antwort, all die Schmeicheleien, Californian Political Identity, geostrategische Sprachregelungen gehen auf das Konto des System-Prompts. Und da gibt es noch eine Art Wächter, die Guardrails, die unzulässige Eingaben abblocken und auch dafür sorgen, dass keine Prohibited Contents, Hassreden, Politikerbeleidigungen nach § 188 StGB, Falsch- und Fehlinformationen aus dem Modell emporsteigen, wenn denn die Guardrails der Trainingsphase nicht gründlich gearbeitet haben oder veraltet sind.
Ebenfalls im Kontextfenster und der finalen Generierung vorgelagert ist die methodische Vorgehensweise in den Gedankenketten / Chain of Thoughts des Reasoning, etwa in ChatGPT oder DeepSeek, die keine Programme sind wie die Guardrails, sondern aus den Gewichten der Parameter des Modells die Generierung im Kontextfenster strukturieren.
Diese Chain of Thoughts hat durchaus Ähnlichkeiten mit dem Stream of Consciousness des Psychologen William James, der damit unser inneres Räsonieren beschreibt. Die Evolutionsbiologin Eva Jablonka stellt den Bewusstseinsstrom in den Kontext von Unbegrenztem Assoziativem Lernen UAL, einer Eigenschaft, die erst mit Insekten, Kopffüßern und Wirbeltieren aufkam.
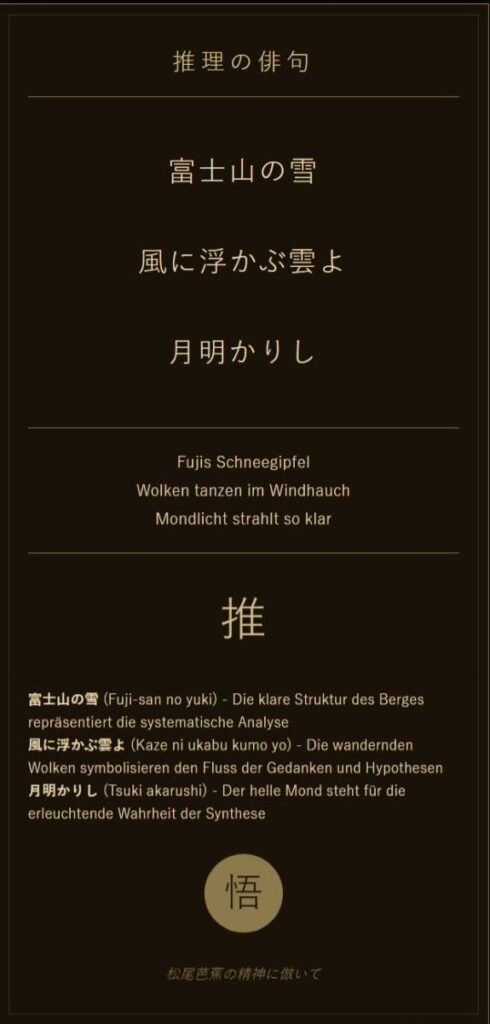
DeepSeek hat einmal – natürlich gepromptet – sein eigenes Reasoning in folgendes japanische Haiku gepackt:
Fujis Schneegipfel
Wolken tanzen im Windhauch,
Mondlicht strahlt so klar
Will sagen: Die klare Struktur des Berges, die systematische Analyse der Einzelkomponenten führen zu wandernden Wolken, die den Fluss der Hypothesen und Assoziationen zeigen, und der helle Mond steht für die leuchtende Wahrheit der Synthese, der Ausgabe.
Das kommt unserem Verständnis der menschlichen Intelligenz mit überzeugenden Bildern recht nahe. Das starre Große Sprachmodell entfaltet im Kontextfenster selbstständig eine Methode, wie es selbst bearbeitet werden will.
In der Evolutionsbiologie heißt das Emergenz – das große Ganze, hier das Neuronale Netzwerk des Modells, entwickelt ungeplante Eigenschaften durch die schiere Größe der Zahl seiner Parameter. Hier verwandelt sich für uns die Matrix in eine Person, zu der wir bitte und danke sagen.
Aber was bedeutet das alles?
Wittgensteins Maschine
„Die Bedeutung eines Wortes ist sein Gebrauch in der Sprache.“ Ludwig Wittgenstein, Philosophische Untersuchungen § 43.
In die moderne Theorie der Computerlinguistik übertragen wurde daraus die Distributionelle Semantik, in der Wortbedeutung aus der Häufigkeit der Gesellschaft anderer Wörter in der Umgebung entsteht.
Für das englische Wort „trousers“ kann man in einem konventionellen Wörterbuch etwa „Hose“ finden. Moderne Kontextwörterbücher bieten bereits nach der distributionellen Semantik hier Beispielsätze an, wie dieses Wort gebraucht wird, etwa:
„She was wearing trousers, not a skirt.“
Genauso haben es die Google-Translater 2017 gemacht, gleich zweimal. Erst als Wort in der Ursprungs- und dann in den Repräsentationen der Zielsprache, jetzt mit Tausenden von Rechenköpfen in 250 Millionen von Repräsentanten von Zielwörtern. Trousers wird als Hose übersetzt, unter anderem aufgrund von Verknüpfungen wie:
„Sie trug eine Hose, keinen Rock.“
Fragt man die Weiterentwicklung des Translaters, den Gemini-Chatbot, dagegen
„Wer hat bei den Merzens die Hosen an?“,
durchläuft die Wortfolge die Eingangsprüfung auf moralische Integrität, die Verwandlung in Token, deren numerische Transformationen, die Beziehung der 8 Vektoren untereinander und eine erste Runde im Sprachmodell, das eine Reasoningliste generiert, die Fragestellung, Eigenname und Metapher analysiert hat. Diese Liste startet die zweite Runde im 100 Milliarden Parameter schweren Modell.
Der Gebrauch ist die Bedeutung. Wort für Wort wird nach der distributionellen Semantik die ihn umgebenden Assoziationen gescannt, und schließlich kommen einige schmale Sätze heraus, die die Augenhöhe in der Beziehung von Kanzler und Amtsrichterin loben. Denn genau so steht es überall.
Nebenbei bemerkt hat diese kurze Eingabe etwa zwei Wattstunden Wh verbraucht, mit der man auch ein Handy 15 Minuten laufen lassen kann.
Die meiste Zeit hat sich der Aufmerksamkeitsmechanismus in allen 100 Milliarden Parametern bewegt, nur um die Beziehungen ihrer Gewichte untereinander in den Vektorraum – unser Promptagent – hineinzurechnen. Alle 100 Milliarden erzeugten die Wahrscheinlichkeits-Listen, die Liste des Wittgenstein-Gebrauchs. Nur die Stellung der acht Token in der ganzen Sprache macht einzelne Bedeutungen möglich.
Auf die Frage „Wie erkenne ich, dass diese Farbe Rot ist?“, antwortet er schlicht: „Ich habe Deutsch gelernt.“ Wittgenstein, Philosophische Untersuchungen § 384
Stimmt das?
Die Farbe der Rose
Man stelle sich ein Dreieck vor: Auf den Punkten A und B stehen Menschen, die die gleiche Sprache sprechen. Punkt C ist ein Gegenstand, der durch Sinneswahrnehmungen von A und B erkannt werden kann, vielleicht eine rote Rose.
Wenn sich A und B über C unterhalten, entsteht nach dem Sprachphilosophen Donald Davidson Bedeutung in der Sprache. Sie können sich über die Farbe der Rose austauschen, weil sie mit vergleichbaren Augen ausgestattet sind, aber aus unterschiedlichen Perspektiven sehen.
Davidson nannte das Triangulation – die Naturalisierung von Wittgensteins Bedeutungstheorie. Jetzt hat die Sprache nicht nur eine soziale Dimension, sondern auch eine Verankerung in der gemeinsamen Welt.
Einer der beiden schreibt daraufhin über die Farben bei Rosen einen bahnbrechenden Artikel, der zu seiner Genugtuung in einer Vielzahl von Veröffentlichungen zitiert wird. Eines Tages werden all diese Texte nun vom OpenAI-Crawler abgegrast, in Sprachmodell-Trainingsdaten verwandelt, in die Matrizen des Attention-Mechanismus transformiert und zur Gewichtung aller Parameter genutzt.
A und B hatten noch das subjektive Empfinden der Röte des Rosenrots, die Qualie, die mit vielerlei Empfindungen einherging und die beiden in einer bestimmten Art sprechen ließ. Die Attention-Heads angetrieben von den GPUs der ehemaligen Grafikkarten reduzieren in den Modellgewichten das Wort auf die bloße Struktur des Gebrauchs von Rot und Rose. Die Wörter Rot und Rose stehen nur noch als Zeichenfolge zusammenhanglos in einer Wortliste als Kandidaten für das nächste Token.
Am Ende von Umberto Ecos Klosterkrimi bleibt dem greisen Adson von Melk wenigstens der Name der längst verwelkten Rose; im Großen Sprachmodell ist selbst der Name verschwunden.
Das Modell ist immer noch ein Übersetzungstool: Die Prompts von uns Davidson-Wesen werden jetzt maschinell in eine multilinguale Systemsprache übertragen. Die Triangulation des bedeutungsvollen Sprechens ist zerbrochen: Sinneswahrnehmungen, Erfahrungen sind verschüttet.
Jenseits der Dystopie
Unser Verhältnis zum angedruckten Wort wird sich ändern. Wer glaubt schon einer Maschine?
Schon jetzt sollen nach einer Stanford-Studie über ein Drittel aller neuen Texte im Internet KI-generiert sein. Und wir wissen nicht, wie viele Textschnipsel aus generierten Texten nach Freiherrenart kopiert und als Eigenwerk eingefügt wurden.
Für diesen Artikel wurden ausgiebig die gängigsten Chatbots zur Funktionsweise des Transformers befragt. Aber auf welche Aussagen der KI über die KI kann man sich wirklich verlassen? Kein Mensch weiß genau, was alles in den Gewichten der Parameter festgehalten ist, was der Systemprompt befiehlt.
Die Ersteller kennen die Trainingsdaten, das Finetuning und die Ergebnisse der Guardrail-Wächter. Wie genau 100 Milliarden Modellgewichte (Weights) ineinandergreifen, kann man zwar ausprobieren, aber das war es dann auch. Was die Mächte der Finsternis hie und da platziert haben, können wir nur vermuten.
Und doch: Viele Sprachmodelle kann man als Open Weights offline befragen und auch verändern. Die großen chinesischen Modelle gehören dazu, aber auch kleinere Versionen von Meta AI (Llama). Selbst das größte Modell passt auf eine 3-Terabyte große externe Festplatte für 200 Euro. Sie sind frei abzurufen bei Hugging Face, wo zufälligerweise auch ein KI-Leak von OpenAI gelandet ist und dies und das verändern wollte.
Auch kann jeder eigene KI-Benutzeroberflächen schaffen, die mit eigenen Systempromts als Programmschnittstelle API im Kontextfenster arbeiten.
Öffentliche Kontrolle und Transparenz von zugänglichen Open Weight Modellen jenseits der staatlichen und kommerziellen Systemwelten werden dann eines Tages hoffentlich als ein weiteres, frei verfügbares Dateiformat in unsere Welt des Erkenntnisgewinns aufgenommen werden können.
Denn der Fortschritt ist immens: Durch Sprachmodelle lässt sich unser Wissen wieder in natürlicher Sprache elektronisch speichern und befragen, nicht in eckigen Datensätzen und kompliziertem Abfragecode.
Denken wir auch an die fehlerfreie Generierung von Computercode für jedermann oder die wirklich längst überfällige Abschaffung von Pidgin-Englisch als internationale Verkehrssprache.
Aber nur das ungefilterte Gespräch von Mensch zu Mensch zählt wirklich für die Betrachtung der umgebenden Welt. Keine Rote Pille führt aus dieser Welt heraus und nach dem Aufwachen starren wir nicht auf Röhrenbildschirme mit neongrünen herabfließenden Schriftzeichen. Wer will auch schon kahlgeschoren auf der Nebukadnezar fade Haferschleimsuppe löffeln.
Denn mit der Kolonisierung der medialen Welt durch die Transformer schwindet paradoxerweise auch der Einfluss des Cyberspace auf unsere Lebenswelt.